站內精準搜尋

2014年11月6日 星期四

20141106《字源》(全三冊)筆畫檢字表數位化完成
20141106《字源》(全三冊)筆畫檢字表數位化完成


old:http://blog.yam.com/ebag/article/81183082


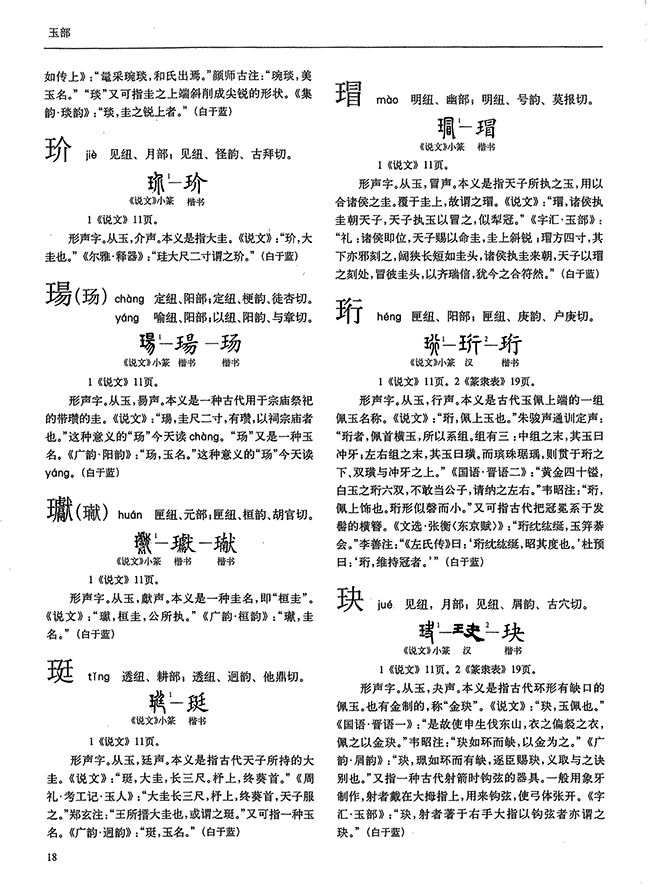
    今日完成了《字源》筆畫檢字表,45頁的內容除了逐字校正之外,主要時間是花在缺字的處理上,完成後很直覺的就想看看學者們對於「願」字的看法是如何。「願」字在《字源》分別是776與779頁,因為該書沒有針對字體有完整的考察(墨跡為主,其餘字類為輔),所以文中的分析之後,還是無法完全理解「願」字演進的原因。

    筆者認為是文字學者所使用的字典或文字資料涵蓋的層面不夠的原因,雖然有點老王賣瓜的嫌疑,但筆者不得不繼續說,如果研究者可以使用「引得市」的檢索,就能彌補這樣的問題,從單字仔細的考察,時段以「秦漢之間」即可,這樣下來,對於《說文解字》篆字形體的疑慮就可以獲得解決。

    去年年底曾對「願」字的演進作了初步考察(見文後連結),對《說文解字》「願」字的篆形有了質疑,個人認為應該是宋人以「楷」形所研判而成的「篆」形,從出土的文字與各類文字資料中,秦漢之際甚至到東漢都不曾有「原」+「頁」這樣的篆形。宋人偏旁拼湊而成的可能性相當的高,最後楷書形成的「原」形。研究的經驗告訴我,這種以「楷」而類推回「篆」形的例子不少,因此筆者其實不太願意相信《說文解字》所列出的的篆形。(篆形形體有誤的話,所分析的內容文字自然也是不會真)

    「願」字的偏旁「原」形,在秦漢以前是以近似「目一目大」或「貝貝大」這樣的形體呈現,經過幾百年的演進,在宋代時才形成目前我們所看到的「原」形,所以在許慎《說文解字》成書的時代(西元100年),甚至更早的秦代,篆形是不可能向我們看到現在看的《說文》版本的樣子。

    嚴格來說唐宋之後,許慎《說文解字》內容樣貌可能已經很難真實的呈現在世人眼前,多少內容是後人所「添加」,多少這樣未知的「成分」已經不容易分別出來。幸好,現在我們可以透過秦漢之間出土的墨跡文字來分析,把《說文解字》的字形形體與墨跡文字相較,就可以明白前者的問題在哪裡,只要研究者不要再落入篆隸字體的分別的矛盾中。

另外,衷心建議要研究或撰寫這類漢字演進的文章之前,還是要把《說文解字》先仔細的過濾一遍,其中形體的錯誤太多,會導致以《說文解字》形體分析漢字演進的研究者錯上加錯。若花了時間卻無法達到正確的研究是很可惜的。

《字源》
字例7867
缺字39
總字例7906

本文(1-1293)
筆畫檢字表(1329-1374)

PS:《字源》裡面有很多缺字是楷形簡體字呈現的的古文字,例如:「軨」(車令)變成「车令」,個人覺得並不大需要,這樣的列示意義不大。古文字學大致上應該還是以楷形繁體字為終點,近代的簡體字的改變與推動,和古文字的演進應該沒有關係了。


《字源》筆畫檢字表使用方式:
請進入「引得市」,點選上方「通假」即可檢索。
www.mebag.com/index


李學勤,《字源》(全三冊),天津:天津古籍出版社,2012年12月。(2013年7月重印)
isbn:978-7-5528-0069-2


筆者校正處:
《字源》筆畫檢字表第1341頁第9畫「𥁋」字非448,應改為447頁。


「願」字的演進(草稿)20131226
http://blog.yam.com/ebag/article/71726759

2014年10月28日 星期二

20141028《清華大學藏戰國竹簡(壹-參)文字編》筆畫檢字表數位化完成

20141028《清華大學藏戰國竹簡(壹-參)文字編》筆畫檢字表數位化完成

知乎:https://zhuanlan.zhihu.com/p/52570048


http://blog.yam.com/ebag/article/80811364

    筆者曾在2013年6月完成《清華大學藏戰國竹簡(壹)》筆畫檢字表的數位化,近日有幸獲得新的資料,覺得應該優先處理。所以暫時將《楚簡帛通假彙釋》筆畫檢字表的處理暫停。大約二三天時間完成這份檢字表。此文字編大約又新增了三百多字的缺字,大約有一半是新造的缺字,一半是原始資料庫就已經有的。

字例 1093缺字 616總字例 1709


    《楚簡帛通假彙釋》若繼續處理,筆者估計可能還會再增加數百個缺字,總累積的缺字應該會突破六千字。這樣一來,不論是秦楚或其他系別的涵蓋量應該就算很大了。雖然一字一字的造字繁瑣耗時,但想到之後可以利用這樣的檢索,讓研究者省下不少時間,覺得幾天的工作量其實也不算什麼了。

    其實,這樣的缺字整理,不僅是便於網路上資料庫的檢索而已,此外,這樣將近六千的缺字本身可以是一個單一的「字型檔」,使用者可以像一般安裝字型的步驟一樣,安裝後,電腦就可輸入或顯示這些缺字,不只是論文文書上的使用,甚至未來若要出版印刷也是沒有問題。所以,一次把缺字的問題處理好,就會像是「倒吃甘蔗」一樣,越來越能體會它的便利性。

    筆者知道目前研究者大部分都是各作各的,每個學校機關都有其整理編製的研究資料,並不是那麼公開或自由交流。但是,如果有研究者需要這樣的檢索表電子檔,在能交流共享互惠的基本條件下,筆者會很樂意共享的。


    朋友們若對文字的整理或校正有興趣,請與筆者聯絡。只要利用一些軟體,不一定得要中文相關科系,也可以馬上上手,將這些文字內容校正數位化完成。


使用方式:


請搜尋「引得市」或輸入「http://www.mebag.com/index/」

點選右上方「楚文字」即可開始搜尋使用,若要搜尋缺字,建議先從「古文字缺字資料庫」查詢,再連回資料庫。


「古文字缺字資料庫」累積缺字已達5809字
「古文字缺字資料庫」http://www.mebag.com/index/quezi/list.asp

    「古文字缺字資料庫」是聯繫各個資料庫缺字的重要核心,古文字的研究者應該要好好的利用。所謂的「缺字」,在此是指目前出版的古文字相關字典或文字編中,電腦無法正常輸入或顯示的字,自2004年起,筆者根據古文字相關文字資料的內容,將這些缺字整理分類與編號,整理成一缺字資料庫。(前身:印學缺字資料庫)

其中也包含目前WIN8作業系統支援的擴張C或D等。為了讓使用者不必背誦編號,我們建議使用者以「構字式」,將原始缺字先拆字的方式來查回缺字,例如:若想查詢「㱕」(舉例,這字不是缺字)可以輸入「止帚」。

基本上這樣的構字式,筆者拆分以從左至右,從上至下的順序。並以目前容易輸入顯示的偏旁字元部件為主,不一定會拆分到最詳細的部件。

※缺字檢索小技巧:

若輸入「匚%戈」可以查到「匚+戈」中間任何一個字元或內容的缺字,即「%」這個符號可以代表任何字元,如果剛好遇到其中一部份的偏旁部件無法輸入,或不會打的情形,就可以用「%」這個符號代替。如圖所示。

再舉一例,輸入「宀%心」即可查到「宀+心」中間有任何一字元部件內容的缺字,這樣可以避免輸入太少的偏旁而有過多的內容。查缺字後,可點選右方五大類的資料庫連結,查回該缺字在文字編的頁碼。

※從缺字資料庫的缺字查詢其他文字編的內容

點選「楚文字」,即顯示該缺字在「楚文字」資料庫中,某一文字編的頁碼


20260918《漢文佛教目錄研究》目錄索引數位化完成

 20260918《漢文佛教目錄研究》目錄索引數位化完成 知乎: https://zhuanlan.zhihu.com/p/2084275584914531398 【訂閱支持引得市】 https://www.mebag.com/index/donate.asp 台灣大專院校、機構...